Voici le troisième volet de notre série d'articles en quatre parties consacrée à la manière dont nous utilisons la plateforme Tanium au sein de notre propre organisation. Dans cet article, Greg Pothier, ingénieur SecOps, explique comment associer Tanium et Splunk pour générer des données relatives à la gestion des correctifs, que les responsables de la sécurité (CSO) et autres responsables de la sécurité peuvent exploiter pour évaluer les risques potentiels.
Suivi de la durée moyenne
Dans quelle mesure serait-il utile de suivre le délai moyen de mise à jour (Mean Time to Patch) pour chaque appareil de votre réseau ? Et si vous pouviez fournir instantanément des résultats précis sur le nombre de correctifs en attente, dès que votre directeur informatique, votre responsable de la sécurité ou votre directeur des opérations vous le demande ?
Ce sont là des questions que nous avons commencé à nous poser ici, chez Tanium. Ces réponses présentent une réelle valeur ajoutée pour nos responsables de la sécurité et de l'informatique, qui peuvent utiliser ces données pour surveiller en permanence notre surface d'attaque et l'efficacité de nos correctifs.
Il est vrai que la plupart des entreprises ne connaissent même pas l'état actuel des correctifs sur l'ensemble de leur réseau, mais chez Tanium, non seulement nous disposons de cette information, mais nous avons également mis au point un indicateur permettant de suivre le temps moyen nécessaire à l'application des correctifs.
C'est la méthode la plus précise que nous utilisons chez Tanium pour exploiter la plateforme Tanium afin de recueillir des indicateurs sur l'efficacité de la gestion des correctifs au sein de notre organisation. Tanium facilite l'obtention de résultats précis, tels que la liste des correctifs critiques non appliqués et l'état de chaque application installée, même au sein des plus grandes entreprises. Pour les responsables de la sécurité des systèmes d'information (CSO) et autres responsables de la sécurité, disposer d'un aperçu des vulnérabilités non corrigées au sein de l'entreprise constitue un indicateur clé, car cela leur permet d'évaluer les risques potentiels. Grâce à Tanium, nous pouvons aller plus loin en évaluant l'efficacité de notre processus de mise à jour, notamment en mesurant le temps moyen nécessaire à l'application des correctifs à l'échelle de l'entreprise. Voici comment nous procédons, à l'aide de Tanium et d' : ; Splunk : (s'ouvre dans un nouvel onglet) ;; , un outil d'analyse de données.
Tanium Connect
Tout d'abord, nous avons configuré un Tanium Connect (s'ouvre dans un nouvel onglet) qui transmet à Splunk notre requête Tanium : « Récupérer le nom de l'ordinateur, le système d'exploitation et les correctifs disponibles sur toutes les machines. » Le système d'exploitation est facultatif ; nous l'ajoutons au cas où nous souhaiterions, à l'avenir, filtrer les résultats en fonction de systèmes d'exploitation spécifiques.
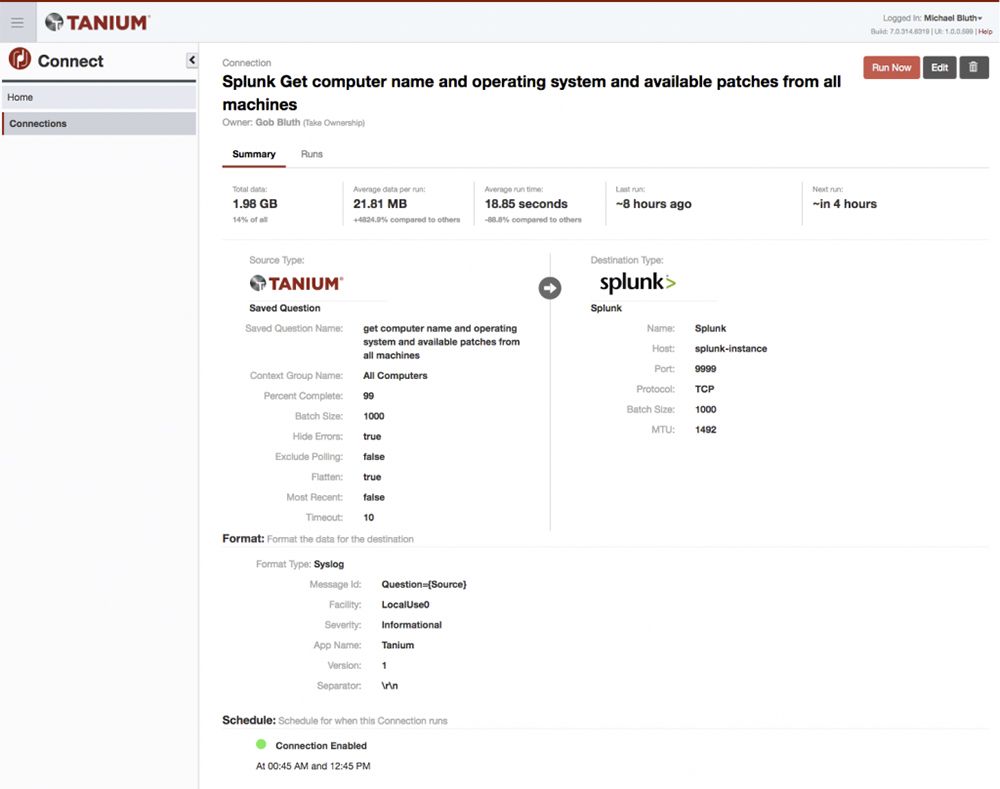
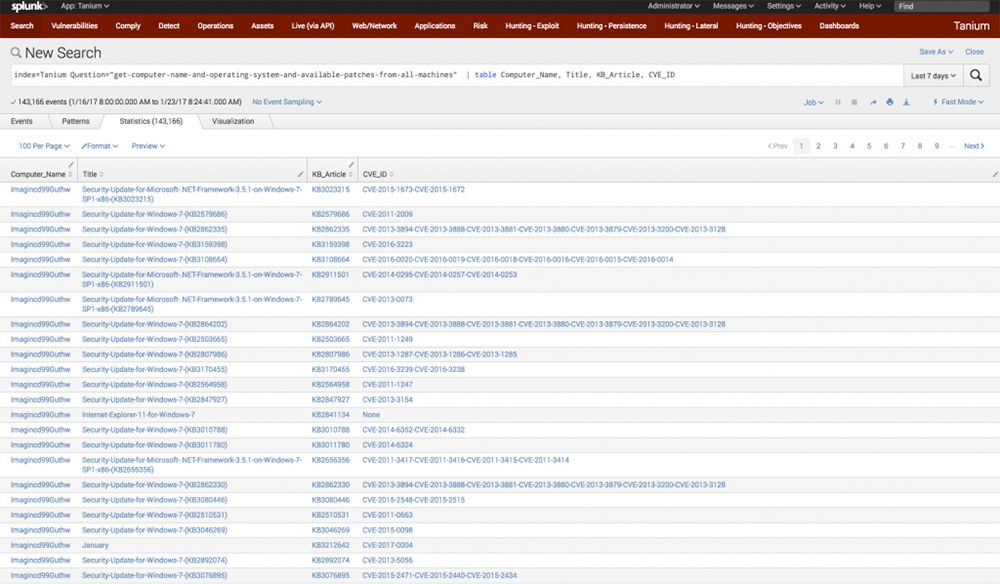
Une fois la connexion créée dans Tanium, nous l'exécutons et vérifions dans Splunk que les résultats sont bien traités comme prévu. Nous commençons la recherche avec la requête index=« tanium », car nous avons configuré cette connexion pour qu'elle soit indexée sous le nom « Tanium ». Ensuite, nous ajoutons ce qui suit :
<code>index="tanium"
Question="Récupérer le nom de l'ordinateur, son numéro de série et les correctifs disponibles sur tous les postes"
</code>Cela vous permet de consulter tous les résultats de mise à jour disponibles, classés par nom d'ordinateur. Nous disposons désormais d'une liste de tous les correctifs, comprenant notamment le titre, le niveau de gravité, le CVE_ID, etc. (Note de : nous utilisons un tableau pour présenter les résultats dans la capture d'écran ci-dessous à des fins de clarté visuelle uniquement ; cette mise en forme n'est pas nécessaire en soi.)
À ce stade, nous créons une présentation visuelle claire des correctifs, classés par niveau de gravité. Afin de nous assurer de ne pas traiter de résultats en double, nous transmettons les informations de connexion à une fonction de déduplication, telle que :
<code>| déduplication de Computer_Serial_Number, KB_Article, CVE_ID, Title</code>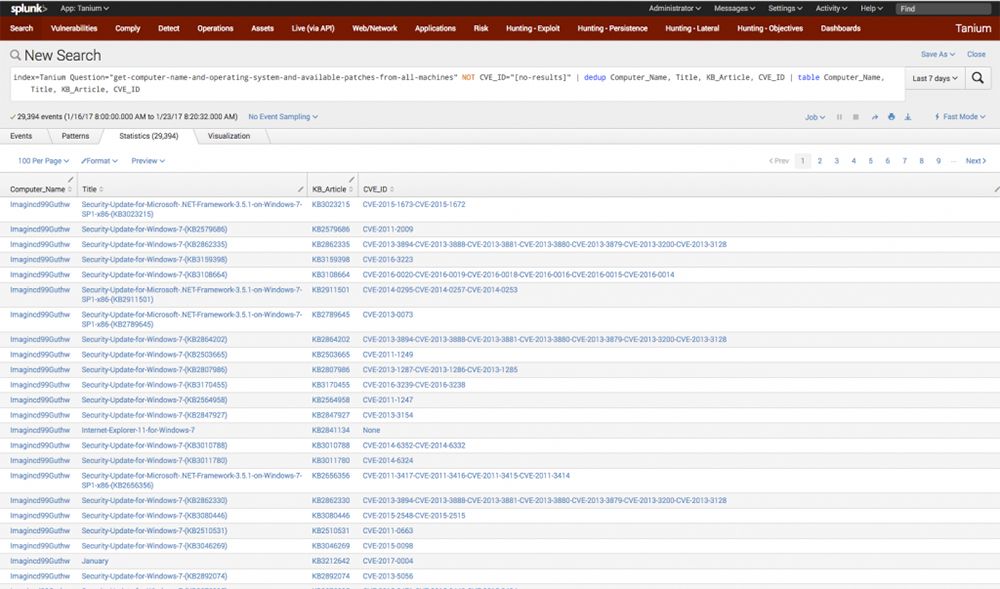
Cela garantit que ces valeurs (Computer_Serial_Number, KB_Article, CVE_ID, Title) ne sont déclarées qu'une seule fois et sont donc uniques. Une fois que nous disposons des valeurs uniques, nous exécutons une fonction simple pour représenter graphiquement les résultats en fonction de leur gravité :
<code>| Nombre de graphiques par niveau de gravité
</code>Les résultats donnent lieu à un graphique clair illustrant le nombre total de cas pour chaque niveau de gravité, ainsi que leur pourcentage :
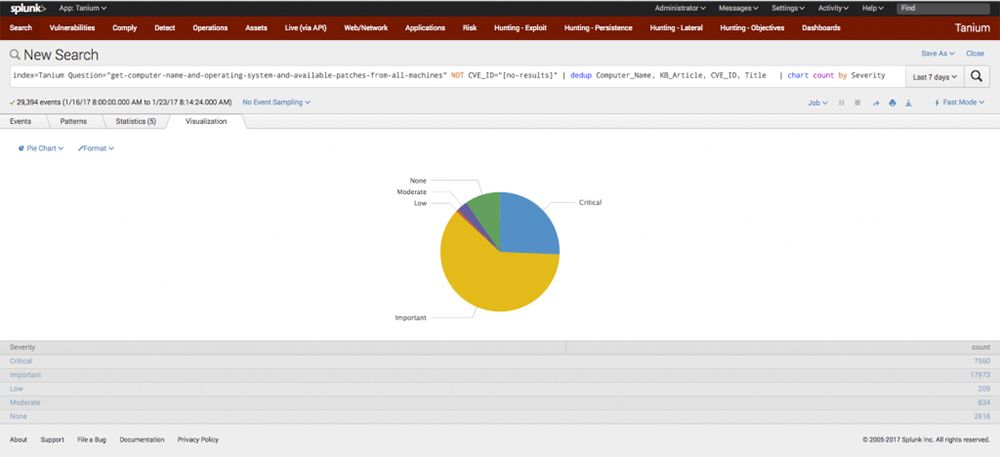
Nous disposons désormais d'un tableau de bord fiable et automatisé présentant les correctifs actuellement ouverts, classés par niveau de gravité. Notez que nous pourrions tout aussi bien procéder de la même manière pour les ordinateurs équipés d'autres systèmes d'exploitation, tels que Linux ou Mac OS X. Poursuivons notre objectif qui consiste à créer une solution automatisée permettant de calculer et d'afficher le délai moyen nécessaire à l'application d'un correctif.
Ensuite, nous revenons à notre requête de base et supprimons la déduplication afin de pouvoir traiter l'ensemble des journaux de correctifs reçus. Ensuite, on ajoute :
<code>| stats earliest(_time) as First, latest(_time) as Last by Computer_Name, CVE_ID, Severity, Title</code>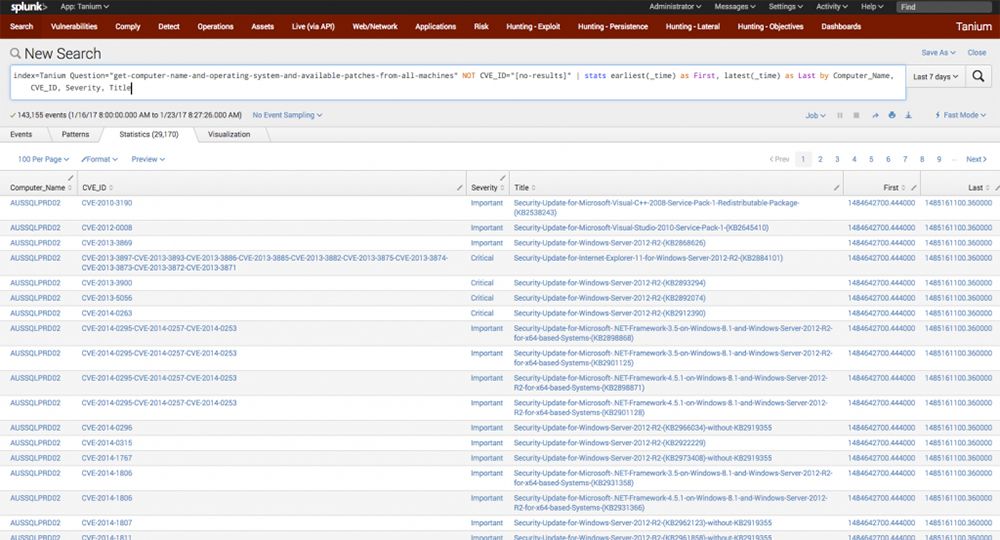
Cette fonctionnalité utilise la fonction « statistiques » pour vérifier la date à laquelle le correctif a été signalé pour la première fois, ainsi que la date à laquelle il a été signalé pour la dernière fois, par nom d'ordinateur, CVE_ID, niveau de gravité et titre. Ce rapport nous indique la date et l'heure auxquelles les correctifs ont été détectés pour la première fois et pour la dernière fois. Nous calculons ensuite la différence entre ces deux valeurs pour déterminer la durée, puis nous convertissons le format « époque » en une chaîne de caractères lisible :
<code>| eval diff = Dernier - Premier | eval diff2 = tostring(diff, « durée »)</code>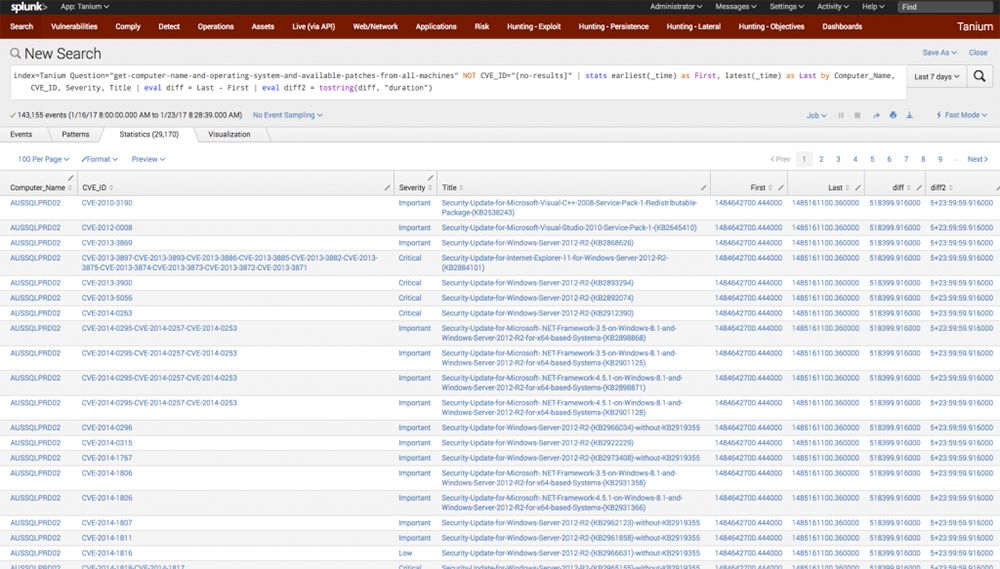
Les résultats indiquent le nom de l'ordinateur, les informations relatives au correctif, ainsi que la durée pendant laquelle chaque correctif a été signalé comme non appliqué sur chaque ordinateur. Nous allons maintenant calculer les valeurs maximales, minimales et moyennes réelles de ces différences :
<code>| nombre de statistiques, max(diff), min(diff), moyenne(diff)
</code>Et voilà. Nous connaissons désormais les valeurs maximales, minimales et moyennes de toutes les zones. Nous rendons le résultat plus lisible en renommant « mean(diff) » en « moyenne », en arrondissant les décimales superflues et en créant une chaîne de caractères bien formatée indiquant les jours, les heures, les minutes, etc.
<code>| renommez « mean(diff) » en « average » | calculez « average » = round(average, 0) | calculez « averageTime » = tostring(average,</code>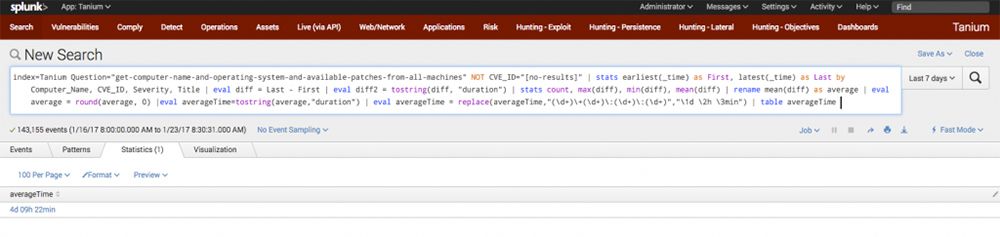
Dans cet article de blog, nous avons utilisé une question enregistrée dans Tanium, transmise une fois par jour via Tanium Connect vers Splunk, afin de créer deux indicateurs automatisés essentiels. Les responsables informatiques peuvent utiliser ces informations pour évaluer notre surface d'attaque et nos performances en matière d'application des correctifs, tant dans la situation actuelle qu'au fil du temps.
Il s'agit de la troisième partie d'une série en quatre parties. Dans l'article « » (), première partie « », je vous explique comment, chez Tanium, nous assurons le suivi des vulnérabilités critiques. Dans l'article « » (), deuxième partie « », je décris comment nous utilisons Tanium pour suivre les indicateurs clés de conformité. Dans l'article « » (), quatrième partie « », je propose des recommandations concernant le délai moyen de réponse et j'explique pourquoi des délais de réponse rapides sont essentiels pour toute entreprise.
À propos de l'auteur : Greg Pothier est ingénieur en sécurité chez Tanium. Il possède une expérience dans les domaines de l'automatisation de la sécurité, de l'analyse de données, des tests d'intrusion et du développement logiciel. Avant de rejoindre Tanium, Greg a occupé le poste d'ingénieur senior au sein de plusieurs agences gouvernementales et de renseignement américaines. Greg a obtenu son master en informatique à l'université George Mason, où il s'est vu décerner la bourse « NSA Information Assurance Cyber Scholarship ».

