
Le travail du service d’assistance consiste à résoudre les problèmes. Pour résoudre les problèmes, vous avez besoin de données. Le type de données dont vous disposez, où et comment elles sont stockées peuvent faire toute la différence pour déterminer la rapidité à laquelle les problèmes sont résolus.
L’idée de collecter des données en temps réel sur les endpoints au sein de l’entreprise aurait pu sembler être un rêve pour les équipes d’assistance il y a quelques années. Mais c’est possible maintenant, et cela crée de nouvelles opportunités pour les centres d’assistance et les employés qu’ils soutiennent.
Dans cette publication, j’explore l’importance des données en temps réel pour les centres d’assistance. Avec des employés plus distribués que jamais, des appareils informatiques plus variés et des menaces de sécurité plus furtives et potentiellement plus dévastatrices, l’obtention de données en temps réel sur les endpoints est une capacité importante.
Minimiser les interruptions et augmenter la productivité
Il existe aujourd’hui un moyen de collecter des données en temps réel à partir d’un endpoint. Appelez l’employé, obtenez sa permission pour lancer un client d’accès à distance sur son endpoint, lancez le client et restez au téléphone pour résoudre le problème.
La collecte de données de cette manière est chronophage et coûteuse. Cela nécessite l’attention à temps plein de l’employé et de l’agent du service d’assistance. Il relie également l’endpoint de l’employé, empêchant cette personne d’effectuer d’autres tâches.
Si la résolution du problème nécessite l’installation d’un nouveau logiciel sous la supervision de l’agent du service d’assistance, ce processus peut glisser pendant une heure ou plus. Cela peut nécessiter plusieurs appels téléphoniques.
L’employé devra peut-être arrêter de travailler pour lancer plusieurs fois des sessions d’accès à distance. Les données collectées sont utiles, mais la manière dont elles sont collectées empêche l’agent et l’employé de travailler sur autre chose.
Et, bien sûr, une fois la session d’accès à distance intrusive terminée, la collecte de données en temps réel s’arrête.
Collecte de données en temps réel sur les endpoints
Une meilleure approche consiste à collecter des données en temps réel sur les endpoints sans interrompre du tout les employés. Avec le bon type d’agent de gestion des endpoints utilisateur installé sur les appareils, il est possible de se connecter au endpoint d’un employé sans lancer de session d’accès à distance.
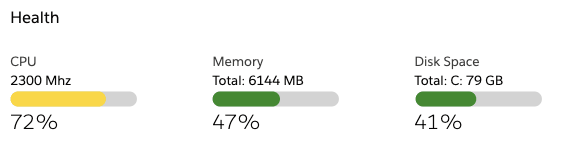
L’agent peut ensuite signaler des données importantes, telles que :
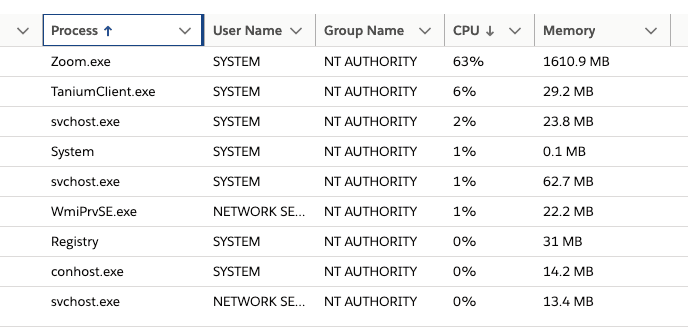
- Quels processus sont actifs ?
- Quels processus consomment l’activité d’unité de traitement (CPU) la plus centrale ?
- Comment la mémoire est-elle utilisée ?
- Quelle quantité d’espace disque est disponible ?
- Quelles versions du logiciel sont installées ?
- Quelle activité suspecte, le cas échéant, a lieu ?
- Quel est le modèle matériel et la configuration de l’endpoint ?
Lorsque les agents du service d’assistance peuvent obtenir ces informations sans interrompre les employés, ils peuvent travailler beaucoup plus rapidement et efficacement.
L’agent peut commencer le dépannage dès qu’un employé demande de l’aide ou soumet un ticket, réduisant ainsi le temps moyen de réparation (MTTR). Et ils n’ont pas besoin d’interrompre l’employé ou de lancer un agent. Ils disposent déjà des informations dont ils ont besoin. Ces informations reflètent ce sur quoi l’employé travaille actuellement, afin que les agents puissent résoudre les problèmes pendant qu’ils se produisent.
Les agents du service d’assistance peuvent accéder à ces données pour résoudre les problèmes de manière proactive, en résolvant les problèmes avant même que les employés ne les remarquent. Par exemple, si les agents apprennent qu’une version spécifique d’une application rencontre des problèmes, ils peuvent mettre à jour tous les endpoints exécutant cette version en arrière-plan.
Cette solution est l’optimisation du service d’assistance : résoudre les problèmes de performance avant même que les employés ne se rendent compte qu’ils ont besoin d’aide.
Poser de nouvelles questions et automatiser plus de tâches
Grâce à l’accès aux données en temps réel sur les endpoints, vous pouvez poser des questions qui n’auraient pas été faisables auparavant. Par exemple, vous pouvez demander :
- Quelle est l’application la plus populaire utilisée dans l’ensemble de l’organisation ?
- Quel processus consomme le plus de processus CPU ?
- Les employés qui ont effectué une mise à niveau vers une nouvelle version connaissent-ils une performance plus lente en conséquence ?
- Si oui, dans quelle mesure ces performances plus lentes sont-elles attribuables à l’ancien matériel ?
- Quels endpoints ont du matériel si ancien qu’il doit être remplacé ?
- Quels endpoints sont particulièrement vulnérables aux nouvelles menaces de sécurité ?
Sans accès aux données en temps réel sur les endpoints, la collecte de réponses à des questions comme celles-ci serait une entreprise monumentale. Cela peut impliquer des jours, voire des semaines de travail avec des agents distants, des enquêtes utilisateur, des feuilles de calcul, des mises à jour d’une base de données de gestion de configuration (CMDB), etc. Avec des données en temps réel, ces questions ont des réponses relativement simples que les agents peuvent traiter rapidement.
Ces données aident également à automatiser les tâches lorsque les agents écrivent des scripts qui ciblent les endpoints qui répondent à des critères spécifiques. Par exemple, vous pouvez écrire un script qui automatise toutes les personnes exécutant une ancienne version de l’application de vidéoconférence standard de l’entreprise. Vous pouvez également écrire un script qui corrige une version d’une application essentielle à l’entreprise, en sachant que vous disposez de données précises et complètes sur les endpoints exécutant l’ancienne version de cette application à ce moment-là.
Stockage des données en temps réel au bon endroit
Vous pouvez voir comment les données en temps réel aideraient à surveiller les performances. Mais savez-vous comment collecter ces données et où les stocker ?
Même avec le coût relativement faible du stockage dans le cloud, maintenir une archive continuellement mise à jour des données en temps réel des endpoints de l’entreprise serait probablement trop coûteux pour la plupart des budgets du centre d’assistance.
Avec la bonne plateforme de gestion des endpoints utilisateur, vous pouvez éviter ce problème en accédant directement aux données en temps réel des endpoints sans avoir besoin que les données soient déplacées et archivées ailleurs.
Conserver les données sur les endpoints permet d’économiser du temps et de l’argent. Les agents obtiennent toujours les informations dont ils ont besoin, et les données sont suffisamment compactes pour ne pas interférer avec le travail quotidien de l’utilisateur. De plus, il n’est pas nécessaire d’intégrer ou de stocker des données supplémentaires.
Transformer numériquement le service d’assistance
J’ai décrit plusieurs avantages des données en temps réel pour les centres d’assistance et les employés. Ces avantages comprennent une résolution plus rapide des problèmes, une réduction du MTTR, un dépannage proactif et l’automatisation des tâches quotidiennes pour les agents du service d’assistance, ce qui permet de gagner du temps pour les employés et les agents.
Il est également possible d’utiliser des données en temps réel pour la transformation numérique. Par exemple, si des scripts automatisés peuvent collecter des informations de statut sur les endpoints, il est possible d’offrir aux employés des portails en libre-service pour mettre à jour ou reconfigurer les applications populaires.
Et les équipes peuvent tirer parti de ces données en temps réel dans des cadres d’intelligence artificielle (IA) tels que Salesforce Einstein pour optimiser les opérations du centre d’assistance. Par exemple, en analysant les problèmes courants des endpoints et les solutions possibles à ces problèmes en fonction des activités que les agents effectuent, il est possible de créer des modèles d’IA qui recommanderaient la « meilleure action suivante » que les agents doivent prendre. Cette « meilleure action suivante » serait basée sur les résultats que le modèle d’IA a observés en dizaines, centaines, voire milliers d’actions.
L’IA devient déjà une ressource plus fiable pour optimiser les opérations dans de nombreux domaines d’activité. Désormais, grâce aux données en temps réel sur les endpoints, cela peut transformer les opérations du service d’assistance.
Créer un nouveau paradigme pour les centres d’assistance
J’ai commencé par dire que le travail du service d’assistance consiste à résoudre les problèmes. Sans un accès pratique aux données en temps réel, les agents du service d’assistance ont dû faire face à des solutions maladroites : des agents d’accès à distance intrusifs, des appels téléphoniques d’une heure avec les employés et du temps passé à regarder les barres de progression se déplacer lentement sur l’écran.
Il est temps pour les équipes du service d’assistance de laisser derrière elles des appels téléphoniques d’une heure et des agents d’accès à distance maladroits. Profitez plutôt des données en temps réel pour découvrir rapidement et facilement ce qui se passe sur les endpoints qu’ils prennent en charge.
En donnant aux agents du service d’assistance un accès en temps réel aux informations de statut et de configuration nécessaires pour résoudre les problèmes, les données en temps réel ouvrent la porte à un service d’assistance plus rapide, plus productif et plus rentable du futur.

