La productivité de toute entreprise dépend des performances des ordinateurs de ses collaborateurs.
Si ces ordinateurs fonctionnent lentement ou tombent en panne, la productivité des employés en pâtira et la réactivité globale de l'entreprise s'en trouvera réduite.
Compte tenu des enjeux considérables, la surveillance des performances constitue un atout essentiel pour toute organisation souhaitant tirer le meilleur parti de ses ressources humaines et de ses technologies.
Voici sept bonnes pratiques pour vous assurer que la solution de votre entreprise surveille de manière efficace et performante les performances des terminaux , tels que les ordinateurs des collaborateurs, les serveurs et autres appareils.
1. Surveiller tous les types de terminaux
On est tenté de faire simple. Supposons que 90 % des terminaux de votre entreprise soient des ordinateurs Windows. Vous investissez dans des outils et mettez en place des processus permettant de surveiller ces machines Windows.
Certes, il existe des serveurs Linux « », mais on ne les trouve pas dans les bureaux individuels ni dans les bureaux à domicile. Et certains cadres adorent leurs Mac. Vous allez partir du principe que ces machines fonctionnent bien ; après tout, personne ne s'en plaint. Et vous disposez de nombreux graphiques pour montrer à quel point vous faites du bon travail avec les ordinateurs Windows.
Mais ces autres critères sont également importants. Et lorsque ces derniers rencontrent des problèmes de performances, cela peut affecter un grand nombre d'autres utilisateurs, directement ou indirectement. (Lorsque le Mac du directeur financier tombe en panne et qu'il ne peut plus valider les achats, cela va en gêner plus d'un.)
Quoi qu'il en soit, veillez à disposer des outils et des processus nécessaires pour surveiller tous les types de terminaux au sein de votre organisation : Windows, macOS et Linux.
2. Surveillez chaque terminal (oui, chaque terminal )
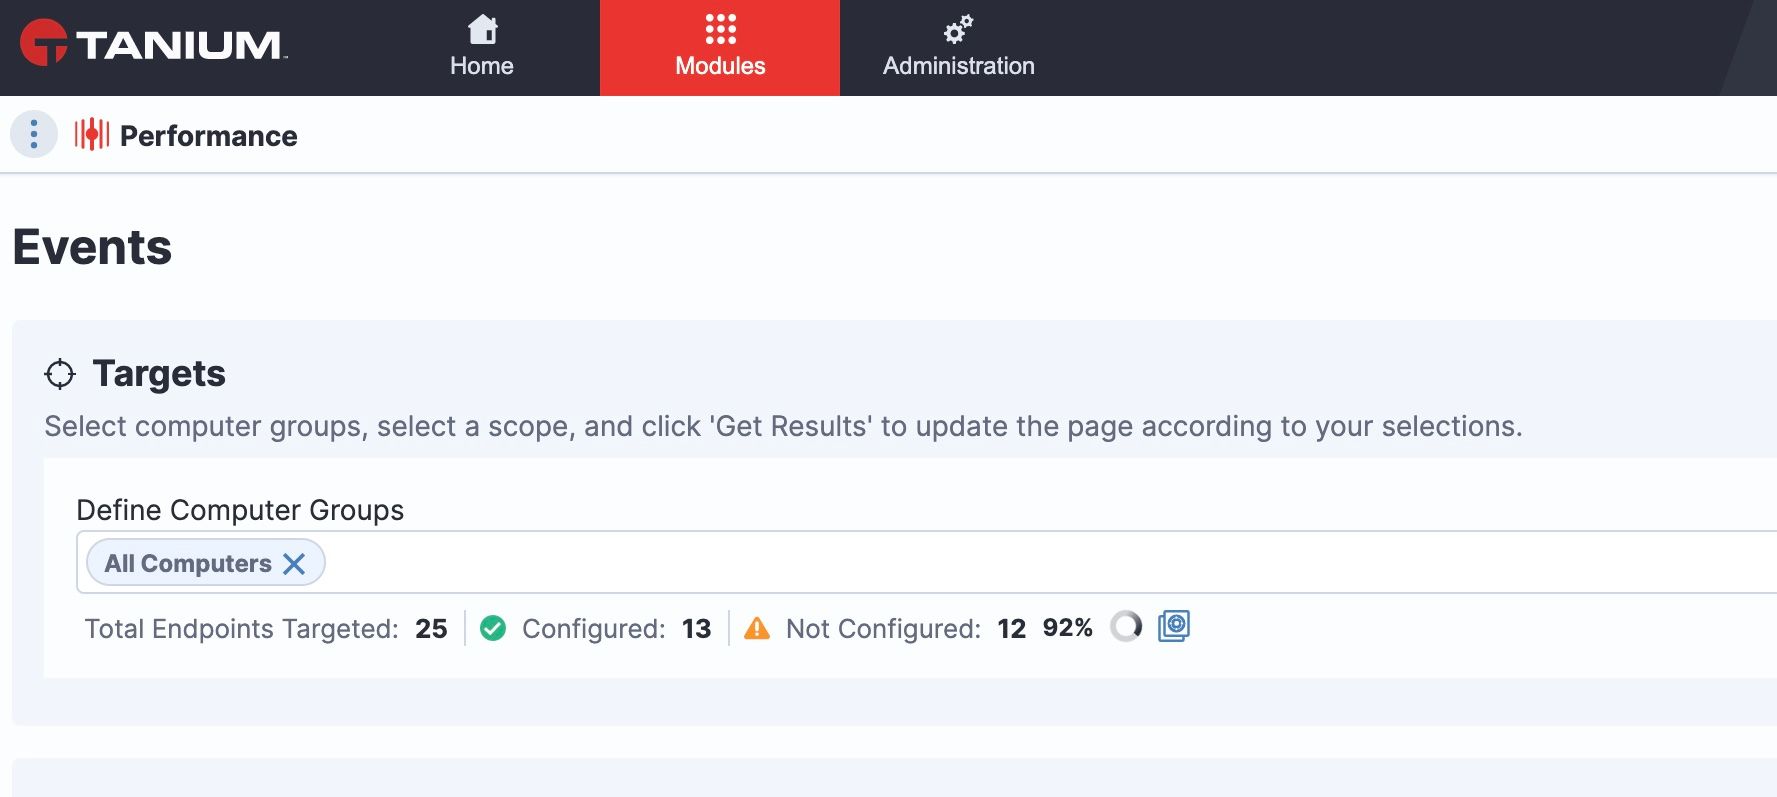
Même si vous disposez d'outils de surveillance pour chaque type de terminal au sein de votre organisation, il y a de fortes chances que vous en négligiez tout de même certains — voire un grand nombre —. Je dis cela car, lorsque nous nous rendons dans des entreprises pour évaluer leurs pratiques en matière de surveillance des performances, nous constatons généralement qu'environ 10-20 % des terminaux ne sont pas pris en compte dans les rapports de surveillance des performances.
Cela signifie que 10-20 % des terminaux risquent de présenter de mauvaises performances, ce qui entraîne une frustration chez les collaborateurs qui les utilisent et une baisse de leur productivité.
D'une manière ou d'une autre, mettez en place des outils et des processus permettant de garantir que vous puissiez réellement surveiller chaque terminal au sein de votre organisation.
3. Ayez une vue d'ensemble
Identifier tous les terminaux est une chose. Permettre aux responsables informatiques et aux responsables des unités opérationnelles d'avoir une « vue d'ensemble » de tous les terminaux gérés est une autre affaire.
Pour assurer un suivi efficace des performances, il est souvent nécessaire d'avoir une vue d'ensemble : cette vue d'ensemble sous forme de tableau de bord qui vous permet de constater, par exemple, que le bureau de Chicago fonctionne bien, mais que celui de Cincinnati connaît des pannes de terminaux dues à des erreurs de mémoire suite à la mise à jour de l'application effectuée hier soir.
Pour surveiller les performances à l'échelle de l'entreprise, veillez à disposer d'une vue d'ensemble de l'entreprise, ainsi que d'une vue détaillée de tous les terminaux rencontrant des problèmes de performances.
4. Veillez à ce que cela reste simple pour les utilisateurs finaux
Dans de nombreuses entreprises, lorsqu'un collaborateur signale un problème de performance au service d'assistance, ce n'est que le début des perturbations dans son travail. La plupart des plateformes de surveillance des performances obligent les ingénieurs informatiques à interrompre le travail des employés ou à entrer en concurrence avec celui-ci pour résoudre le problème.
Il se peut que l'employé doive accepter une demande d'installation d'une nouvelle application de diagnostic ou de contrôle à distance sur son terminal. Il se peut que l'enquête sur ce problème ne puisse débuter qu'une fois que le travail officiel — c'est-à-dire les tâches relevant des fonctions de l'employé — aura pris fin. Si le problème était intermittent et résultait de l'activité à laquelle l'employé se livrait, le moment idéal pour le résoudre est désormais passé.
Une meilleure approche ? Utilisez des outils permettant aux ingénieurs d'analyser ce qui se passe sur le terminal sans perturber l'utilisateur. Permettez aux ingénieurs d'analyser les processus, l'utilisation de la mémoire et d'autres données clés sans que l'employé ait à lever le petit doigt, à installer un logiciel client, à cliquer sur des boîtes de dialogue ou à passer une heure au téléphone.
5. Enregistrez localement, résolvez les problèmes à l'échelle mondiale
L'une des raisons pour lesquelles tant de plateformes de surveillance des performances s'appuient sur des techniques d'analyse intrusives est qu'elles n'ont que peu, voire aucun accès aux données relatives à l'activité des terminaux tant que les ingénieurs ne se sont pas effectivement connectés à ces derniers via le réseau.
Cette approche présente deux inconvénients majeurs : elle perturbe les utilisateurs et elle limite l'accès des ingénieurs aux données. Si un problème est intermittent ou lié d'une manière ou d'une autre à une autre activité survenue plusieurs heures ou plusieurs jours auparavant, l'ingénieur chargé de l'enquête risque fort de passer à côté de ces éléments d'information.
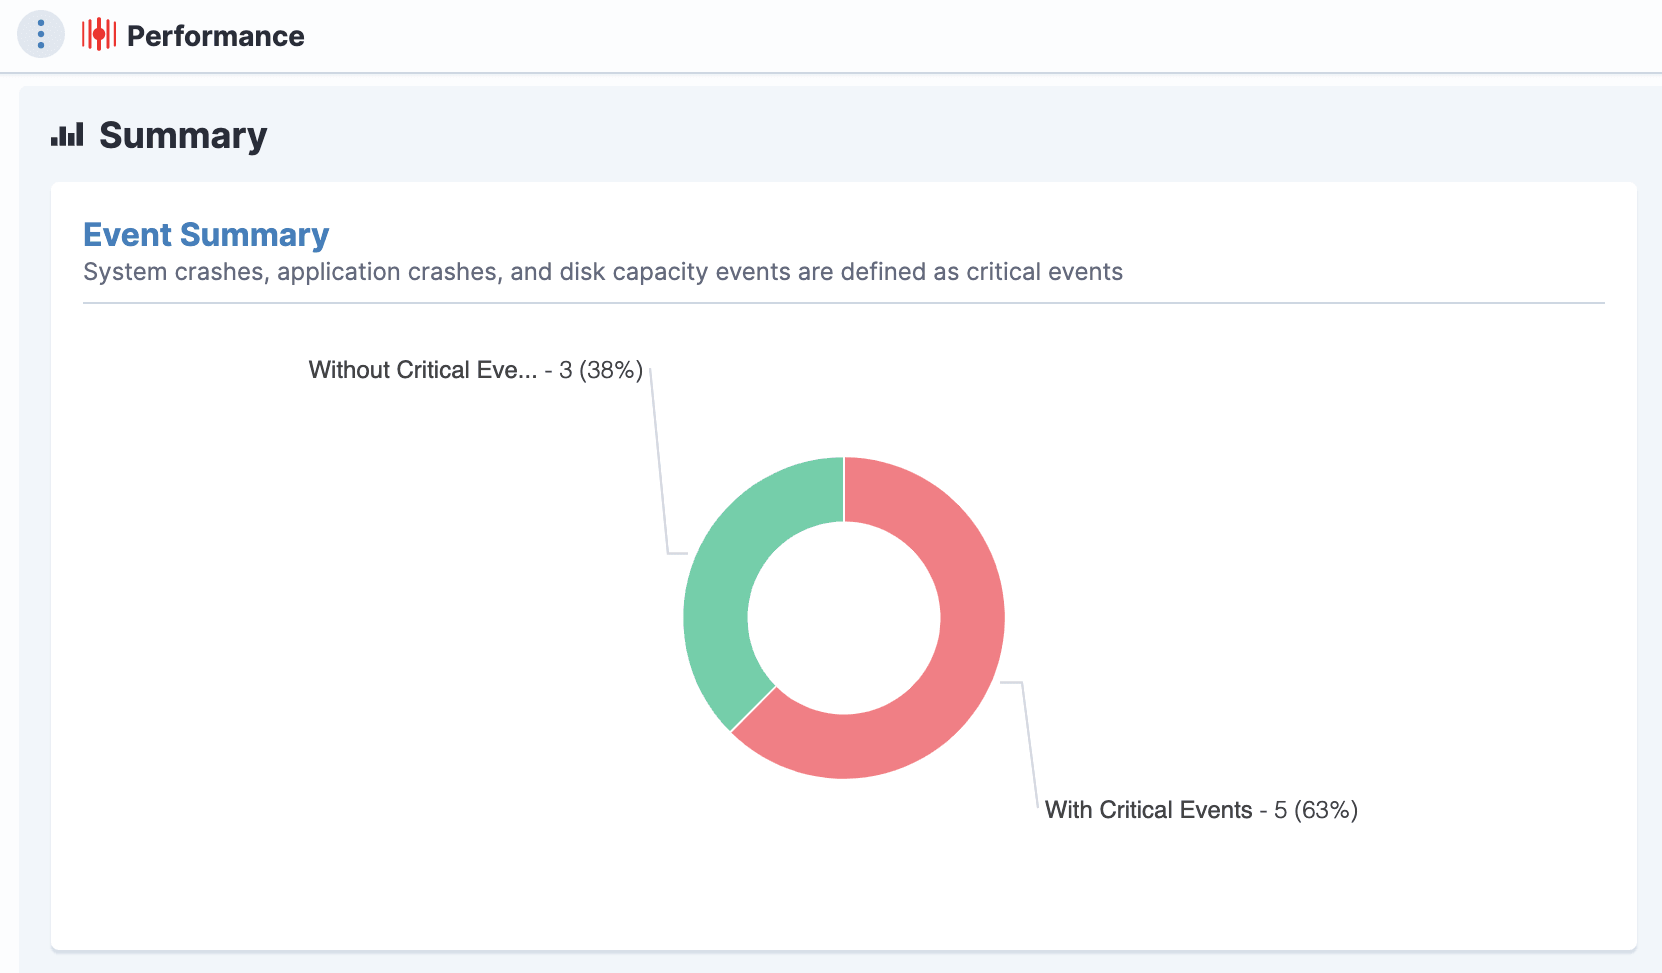
Une autre approche consiste à faire en sorte que les terminaux enregistrent localement les données de performance, de sorte que, lorsque les ingénieurs enquêtent sur des problèmes, ils puissent immédiatement disposer d'une mine d'informations sur lesquelles s'appuyer dans un référentiel de données local.
Comme les données ont déjà été collectées, les ingénieurs n'ont pas besoin d'interrompre les utilisateurs pour les recueillir. De plus, comme les données sont stockées localement, les ingénieurs peuvent y accéder sans que tous les terminaux aient besoin de transmettre en continu des métriques détaillées à une console de gestion centrale.
Pourtant, même en l'absence d'un volume colossal de données circulant sur les réseaux et susceptible d'engorger le trafic, les ingénieurs peuvent dépanner le terminal depuis n'importe quel endroit : un réseau local (LAN) ou étendu (WAN), un centre d'assistance, un centre de contrôle des opérations de sécurité, voire un bureau à domicile.
Il en résulte des informations plus pertinentes pour le dépannage, une résolution plus rapide des problèmes et des interactions plus pratiques tant pour les utilisateurs finaux que pour les ingénieurs.
6. Aidez l'équipe de développement interne
En collectant et en partageant des informations détaillées sur les performances des terminaux, une équipe d'exploitation informatique a la possibilité d'aider l'équipe de développement interne à résoudre les problèmes liés aux applications qu'elle développe pour les collaborateurs.
Les données de performance en temps réel et historiques concernant l'exécution des processus, l'allocation de mémoire, l'utilisation du disque et d'autres indicateurs clés sur des centaines, voire des milliers de terminaux peuvent aider les développeurs à diagnostiquer et à corriger des problèmes qu'ils n'auraient pas pu détecter ou caractériser correctement lors de déploiements plus limités dans des environnements de test.
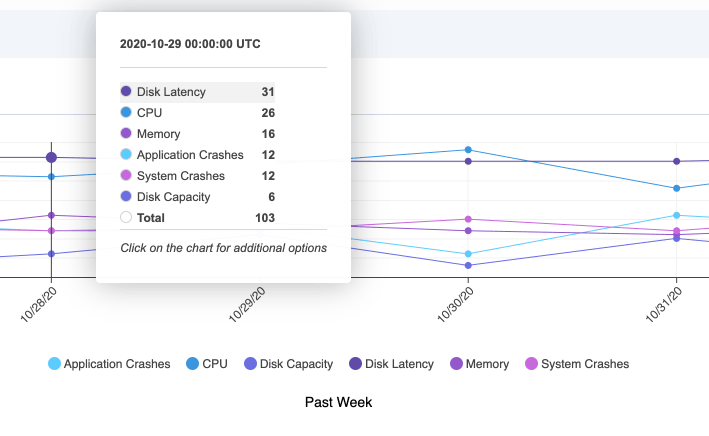
Le suivi des performances peut être considéré comme un outil général applicable à tous les collaborateurs, mais il constitue également un outil précieux pour les équipes de développement — même s’il ne fait pas officiellement partie d’une suite logicielle de développement.
7. Réduire le temps moyen de réparation (MTTR)
Le MTTR ( , ou temps moyen de réparation) est sans doute l'indicateur par excellence de toute pratique de surveillance des performances.
Lorsqu'un problème survient, dans quel délai l'équipe informatique est-elle en mesure de le résoudre ? Peuvent-ils trouver rapidement et facilement les informations dont ils ont besoin ? Peuvent-ils le trouver sans déranger les employés concernés par le problème ?
Le suivi d'indicateurs tels que ceux-ci permet aux services informatiques d'évaluer la valeur de leurs outils et procédures de mesure des performances. Si les ressources humaines, les processus et les technologies que vous utilisez pour le suivi des performances ne permettent pas de réduire le MTTR, cela signifie que vos ressources humaines, vos processus et vos technologies ont encore besoin d'être améliorés.
En suivant ces bonnes pratiques, vous réduirez le MTTR, optimiserez les performances sans perturber le travail quotidien des collaborateurs, aiderez les équipes de développement internes à résoudre plus rapidement les problèmes subtils et bénéficierez d'une réaction plus rapide face aux failles de sécurité et autres risques opérationnels.
Pour en savoir plus, consultez mon précédent article de blog « » et « 10 façons dont Tanium améliore la surveillance des performances » :.
Si vous êtes prêt à le découvrir en action, rendez-vous sur et inscrivez-vous dès aujourd'hui à une démonstration sur .

